Med statistikfunktionen i Korp kan du se fördelningen av attribut för en sökfråga. Till exempel fördelningen av politiska partier bland motioner som innehåller "krig" (djuplänk till sökningen).
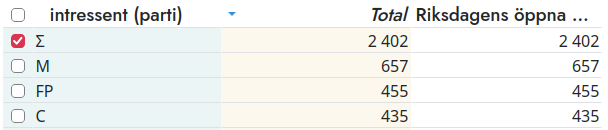
Talen i varje rad anger antal token som matchar både sökfrågan och attributvärdet på den raden. Läs mer om statistikfunktionen i användarhandledningen.
Men hur gör du om du inte vill räkna token, utan antal texter? Vilka ord förekommer i flest antal dokument?
Eftersom vi inte har någon sådan funktion inbyggd är svaret lite komplicerat. Läs instruktionerna i våra Frågor och svar: Hur räknar jag antal texter i Korp?